2026-11-13Yapay Zeka · Bilgisayarlı Görü · Doğal Dil İşleme · Robotik
Bugünkü sayıyı tek bir soru bağlıyor: Yapay zeka dünyayı gerçekten nasıl "görüyor" ve ne kadar güvenilir biçimde kavrıyor? Sürüş ve kamera sistemlerinden konuşma ve uzamsal akıl yürütmeye, oradan genomiğe uzanan çalışmalar, modellerin güçlendiği yerleri olduğu kadar zayıf kaldığı noktaları da gösteriyor. Bu makaleleri yan yana okumak, alanlar arası ortak örüntüleri ve bir sonraki zorlukları tek bakışta görmenizi sağlıyor.
1.Araştırma
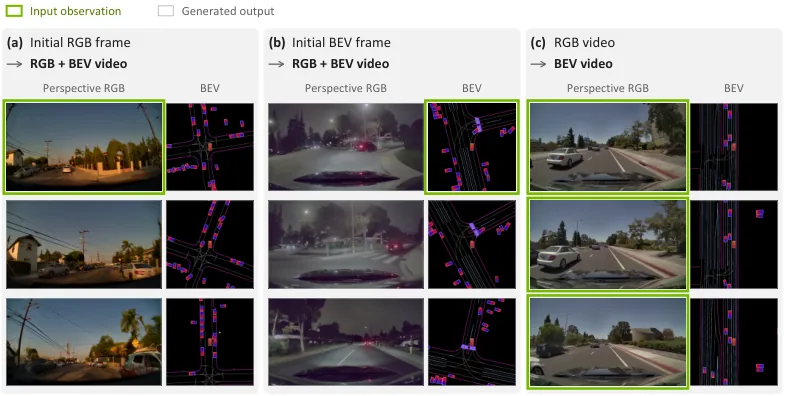
BirdDreams: Kuş Bakışı ve Perspektif Videoyu Birlikte Üreten Sürüş Modeli
BirdDreams, sürüş sahnesinin geleceğini hem perspektif hem kuş bakışı videoyla tahmin eden bir dünya modeli.
BirdDreams, başlangıç olarak tek bir RGB kareyi, tek bir kuş bakışı kareyi ya da tam bir RGB videoyu alabiliyor; ilk iki durumda hem perspektif hem kuş bakışı video, üçüncüsünde kuş bakışı video üretiyor. Görsel: Seo ve ark., arXiv, CC BY 4.0 · kaynak · CC BY 4.0
BirdDreams, perspektif video ile şematik kuş bakışı (BEV) videosunu birlikte üreten otoregresif bir sürüş dünya modeli. Önceki çalışmalar çevre araçların hareketini kontrol etmek için gelecekteki yörüngelerin girdi olarak verilmesini gerektiriyordu; BirdDreams ise sahne düzenini tahmin edilen geleceğin bir parçası haline getiriyor.
BEV akışı, yolları ve araçları sabit metrik ölçekte basit şekiller olarak gösterip araçlar arası örtüşmeyi azaltıyor. Perspektif video ise trafik ışıkları ve nesne görünümü gibi BEV'in dışarıda bıraktığı ayrıntıları koruyor. İki video diffusion transformer arasındaki ortak dikkat mekanizması, üretim sırasında her akışın diğerini bilgilendirmesini sağlıyor. Tahmin edilen BEV aynı zamanda ego kontrolü için geometrik bir arayüz sunuyor: son kare, verilen ego yörüngesi boyunca ötelenip döndürülerek yumuşak bir koşul olarak kullanılıyor. Çıkarım sırasında tek bir kamera görüntüsü yeterli; HD harita veya araç durumu girdisi gerekmiyor.
PhysicalAI-AV ve nuScenes üzerinde BirdDreams, önceki sürüş dünya modellerine göre ego yörüngelerini daha sadık izliyor. İnsan değerlendirmesinde ise yalnızca perspektif kullanan bir baz modele kıyasla çevre araç davranışını daha gerçekçi üretiyor. Bu, otonom sürüş simülasyonunda tepkisel ve inandırıcı dünya modellerine doğru somut bir adım.
BEST-RQ'ya Dağılımsal Sağlamlık: Konuşma Temsilleri İçin Yeni Yaklaşım
Dağılımsal olarak sağlam BEST-RQ, kuantizasyon hedeflerine duyarlılığı gruplar arası yeniden ağırlıklandırmayla azaltıyor.
Rastgele projeksiyon ve kuantizasyona dayanan BEST-RQ, etiketsiz büyük ölçekli ses verisinden konuşma temsilleri öğrenen, yüksek performanslı ve verimli bir öz denetimli öğrenme yöntemi olarak yerleşmiş durumda. Ancak rastgele kuantizasyonla öğrenilen temsiller, kuantizasyon hedeflerinin seçimine duyarlı olabiliyor. Başka bir deyişle, aynı model farklı rastgele kod kitaplarıyla eğitildiğinde tutarsız sonuçlar verebiliyor.
Araştırmacılar bu sorunu, birden fazla kuantizasyon yapılandırması boyunca sağlam temsiller arayan dağılımsal olarak sağlam bir BEST-RQ uzantısıyla ele alıyor. Gruplar kod kitapları (codebook) üzerinden tanımlanıyor ve eğitim, grup Distributionally Robust Optimization (DRO) problemi olarak formüle ediliyor. Yöntem yalnızca gruplar arası ortalama kaybı optimize etmek yerine, kötü performans gösteren grupları adaptif olarak daha yüksek ağırlıkla öne çıkarıyor. Böylece model, tek bir kod kitabına aşırı uyum sağlamak yerine tüm yapılandırmalarda dengeli biçimde öğrenmeye zorlanıyor. Dağılımın aşırı sapmasını önlemek için DRO, Kullback-Leibler ıraksaması ile düzenlileştiriliyor.
Multilingual LibriSpeech veri kümesindeki değerlendirmede yaklaşım, birden fazla kod kitabı üzerinden alınan geleneksel düzgün ortalamaya göre daha iyi performans gösteriyor. Sonuç, rastgele kuantizasyona dayanan öz denetimli konuşma modellerinde hedef seçiminin yarattığı kırılganlığın sistematik biçimde azaltılabileceğini gösteriyor. Bu bulgu, özellikle çok dilli ve büyük ölçekli konuşma modellerinde daha tutarlı ve öngörülebilir ön eğitim süreçlerinin önünü açabilir.
AI100 Raporu: Somutlaşmış Yapay Zeka Büyük Zorluk Olarak Öne Çıktı
AI100 2026 raporu, fiziksel yapay zekayı alanın altı büyük zorluğundan biri olarak işaret ediyor.
Yapay zekanın gelişimini ve toplumsal etkisini izleyen One Hundred Year Study on Artificial Intelligence (AI100) projesinin beş yılda bir yayımlanan raporunun 2026 sürümü çıktı. Seride üçüncü olan raporun başlığı "AI Goes Mainstream: The Scaling Era and the Rise of Generative AI". Uluslararası bir uzman paneli, yapay zekanın evrimini teknik, etik, ekonomik ve toplumsal alanlarda inceleyerek 12 standart soruya yanıt veriyor.
Rapor, alanın açık büyük zorlukları arasında altı başlığı özellikle ilham verici ve bilimsel açıdan önemli buluyor; robotik topluluğunu en çok ilgilendireni fiziksel yapay zeka ve somutlaşmış zeka. 2021'den bu yana doğal dil işlemenin robotik sistemlere entegre edilmesi, eğitim ve kontrol için vision-language-action modellerinin kullanılması ve sanal ortamda eğitilen modellerin fiziksel donanıma aktarılmasını sağlayan simülasyon ilerlemeleri öne çıkıyor. Rapora göre Çin, dünyanın geri kalanının toplamından daha fazla endüstriyel robot konuşlandırıyor ve insansı robotların yaklaşık yüzde 80'ini üretiyor; bu sektör şimdilik pazarın yalnızca yüzde 2'sini oluştursa da hızla büyüyor.
Başarı hikâyeleri hâlâ depo gibi kısıtlı ortamlarda ya da zemin temizleyicileri gibi çok belirli ürünlerde yoğunlaşıyor; gösterilen yetenekler ile gerçek dünyaya dağıtım arasında büyük bir boşluk var. Aşılması gereken sorunlar arasında belirsizlik altında uzun ufuklu planlama, çeşitli nesnelerle el becerisi gerektiren manipülasyon ve biçimsel performans garantileri yer alıyor. Rapor, gerçek dünyanın karmaşıklığının temel engel olmaya devam ettiğini vurguluyor.
RECALL: Çoklu Kamera Düzenekleri İçin Gerçek Zamanlı Yeniden Kalibrasyon
RECALL, taşınabilir çoklu kamera düzeneğini tek geçişte kalibre ediyor; paket ayarlamadan yaklaşık 10^5 kat hızlı.
Çoklu kamera düzenekleri üreticiden önceden kalibre edilmiş gelir, ancak düzenek her yeniden konumlandırıldığında kalibrasyon bayatlar; aşınma, ısıl döngü ve titreşim nedeniyle de sürekli kayar. Klasik bundle adjustment ise yeni bir çoklu görünüm çekimi ve maliyeti düzenekle birlikte artan global bir optimizasyon gerektirdiğinden gerçek zamanlı kullanıma uygun değil.
RECALL, taşınabilir bir çoklu kamera düzeneğini tek geçişte yeniden kalibre eden ileri beslemeli bir yöntem. Üreticinin nominal kalibrasyonunu çıpa olarak alıyor ve bilinen bir nesnenin kısa gözleminden her kameranın güncel içsel ve dışsal parametrelerini tahmin ediyor; çıktı, düzeneğin paylaşılan global dönüşü ile kamera başına küçük bir kaymanın bileşimi olarak yazılıyor. Kalibrasyonu tek seferde regresyonla bulmak yerine, türevlenebilir projeksiyon üzerinden yeniden izdüşüm yapan ve her adımda kameralar arası dikkat uygulayan öğrenilmiş, düzeneğe bağlı bir özyinelemeli operatörle tahmini iyileştiriyor. Paylaşılan dönme ölçeğini de ağ içinde öğrenilmiş bir Gauss-Newton adımıyla çözüyor. Gerçek referans verisi sentezlenebildiği için eğitim tamamen anında üretilen veriyle yapılıyor.
10 kameralı sentetik kıyaslamada RECALL, kamera başına ve düzeneğe bağlı ortak bundle adjustment'tan daha doğru (0,26° ve 0,47° dönüş; 5,4 ve 8,9 piksel odak uzaklığı hatası) ve düzenek başına yaklaşık 0,12 ms ile yaklaşık 10^5 kat hızlı çalışıyor. TotalCapture ve CMU Panoptic gerçek verilerinde mutlak ve göreli dönmede çevrimdışı bundle adjustment'a yetişiyor ya da geçiyor, dört-beş büyüklük mertebesi daha hızlı çalışıyor. Panoptic çevresel düzeneğinde göreli poz bakımından en güçlü görüntü tabanlı foundation modellerle (VGGT, VGGT-Ω, π³) eşleşirken metrik kalıyor ve odak uzaklığında yaklaşık 15 kat daha doğru. Kod açık.
Açık VLM'ler uzamsal kıyaslarda %85-94 alırken, nesne ve doku ipuçları kalkınca basit geometride şansa düşüyor.
Açık ağırlıklı görsel-dil modelleri (VLM) BLINK Spatial ve What's Up CLEVR gibi uzamsal kıyaslarda %85-94 puan alıyor; ancak nesne, sahne ve doku ipuçları ortadan kalktığında basit geometrik sorularda şans seviyesine çöküyor. Araştırmacılar bunu ölçmek için, üç koordinat sisteminde (1D doğrusal, 2D Kartezyen, 2D kutupsal) ve dört soru tipinde (ikili, kategorik, karşılaştırmalı, nicel) eşleştirilmiş renkli nokta bulutu uyaranları üreten, prosedürel ve açık kaynaklı Sophon tanılama aracını sunuyor.
LLaVA-NeXT, LLaVA-OneVision, Qwen2.5-VL ve Idefics3 dahil dört açık mimaride doğruluk %47-52 bandında kalıyor; öncü modeller (Opus 4.6, Gemini 2.5 Pro, GPT-5.4) %77-83'e, insanlar ise %84-94'e ulaşıyor. Lineer probe ve LoRA ile yapılan analizler, vision encoder ve dil kod çözücüsünün uzamsal bilgiyi sırasıyla %83-85 ve %80-86 doğrulukla geri kazanabildiğini gösteriyor. Dil kulesinin akıl yürütme devresi, nokta bulutları koordinat kümesi olarak metinle verildiğinde görsel uyaranlara göre 40 puan daha iyi sonuç veriyor. Modeller doğru yanıt kümesindeki token'ları öne çıkarıyor ancak aralarından rastgele seçiyor.
LoRA ile ince ayar, 7B sınıfı VLM'lerin Sophon sorularına öncü modellerin toplam doğruluğuyla yanıt vermesini sağlıyor. Bulgu, bu modellerde bir yetenek eksikliğinden çok, hedefli ince ayarın onarabildiği bir yönlendirme darboğazı bulunduğuna işaret ediyor.
Dondurulmuş LLM'den Tam Çift Yönlü Kelime Düzeyinde Sesli Diyalog
Dondurulmuş çok modlu bir LLM, yaklaşık 30 GPU-saatte tam çift yönlü sesli diyalog sistemine dönüştürüldü.
Sistemin konuşurken dinleyebildiği, geri bildirim verebildiği, söz hakkını bırakabildiği ve kesilebildiği tam çift yönlü sesli diyalog, genellikle yüz binlerce ila milyonlarca saatlik konuşma verisiyle eğitimle elde ediliyor. Bu yaklaşım pahalı, sistemin bilgisini sağlayan dil modelini yeniden yazıyor ve söz alma kararını örtük ya da kelime kelime olmak yerine kaba bırakıyor.
Bu çalışma, dondurulmuş genel amaçlı bir çok modlu LLM'in az veriyle kelime düzeyinde tam çift yönlü bir sisteme uyarlanabileceğini gösteriyor. Sistem, 80 ms'lik kare saati üzerinde çalışan bir thinker-talker kaskadı. Thinker, LLM'i dondurup yalnızca hafif adaptörleri ve birkaç yeni token gömmesini (97M parametre) eğitiyor; her karede bir ajan metni token'ı üretiyor, duraklama, söz bırakma ve söz alma ise aynı sözlükteki token'larla temsil edilip sonlu durum makinesiyle geçerli tutuluyor. Her aşaması modelin önceki biçimdeki kendi davranışına çıpalanan dört aşamalı bir müfredat, dönüşümü yaklaşık 30 GPU-saatte tamamlıyor. Talker yalnızca thinker'ın ayrık token'larını okuduğundan iki yarı bağımsız eğitilebiliyor.
Full-Duplex-Bench ve InteractionBench'te sistem, büyük ölçekli konuşma eğitimiyle üretilmiş açık kaynaklı tam çift yönlü sistemlerle rekabetçi. Bunlar arasında kullanıcı yalnızca duraksadığında söz alma ihtimali en düşük olanı, en sık geri bildirim vereni; sesli görev doğruluğu, dayanaklılık ve uzun konuşmalarda tutarlılıkta ise öncü konumda.
Gemini 4 Hydrogen, Daha Büyük Argon'u Dört Haftada Geride Bıraktı
Google'ın Flash serisinin yerini alan Hydrogen, benchmark'larda daha pahalı Argon'u geçiyor.
Google, geliştiriciler ve gündelik kullanıcılar için hızlı, genel amaçlı Gemini 4 Hydrogen modelini yayımladı. Derin ve uzun ufuklu akıl yürütme için tasarlanan öncü modeller Carbon ve Argon'un aksine Hydrogen, gündelik görevleri hızlı ve ucuz halletmeyi hedefliyor ve Flash serisinin karşılığı gibi konumlanıyor. Google'a göre varsayılan "high" düşünme seviyesinde Artificial Analysis Intelligence Index'te Argon'u geçiyor (51'e karşı 50); en yüksek "xhigh" seviyesinde 54'e çıkıyor. Artificial Analysis'in bağımsız değerlendirmesi, en yüksek seviyede onu Claude Sonnet 5.5 ile aşağı yukarı aynı düzeye koyuyor; "high" seviyesinde ise GPT-6.1 Sol ve Claude Opus 5.5'in (52) biraz gerisinde.
Hydrogen dört düşünme seviyesi sunuyor (low, medium, high ve yeni xhigh); Argon'da yalnızca medium ve high var. Model, giriş ve çıkış için bir milyon token'lık bağlam penceresine sahip. Fiyat milyon giriş token'ı başına 1,50 dolar, çıkış token'ı başına 7,50 dolar; önbellek isabeti 0,075 dolar. Google'a göre önceki Flash nesline kıyasla sıçrama büyük: varsayılan seviyede görevleri 2,5 kat hızlı bitiriyor, Terminal-Bench 4.1 skoru %18,2'den %57'ye çıkıyor, halüsinasyon beş kat azalıyor. Agent Arena'da beşinci sırada, Vals Tax Agent Bench'te %52,3 ile birinci.
The Decoder'a göre Hydrogen, Argon'dan hem daha yetenekli hem daha ucuz görünüyor. Google iki gün önce Carbon'u duyururken günlük kodlama için Argon'da kalmayı önermişti; yayın, Hydrogen'in bu tavsiyeyi anlamsız kıldığını ve Argon'u çıkışından dört haftadan kısa sürede eskittiğini yazıyor. Model Gemini API, Gemini uygulaması, Google Search ve Google Antigravity üzerinden kullanılabiliyor.
AlphaGenome 2: Genomik Yapay Zeka Tek Hücre Tipi Çözünürlüğüne Geçti
Google Deepmind'ın AlphaGenome 2'si, genetik varyantları doku ortalaması yerine tek tek hücre tipleri için analiz ediyor.
Google Deepmind, genetik varyantların etkisini toplu doku yerine belirli insan hücre tipleri için tahmin eden AlphaGenome 2'yi duyurdu. Selefine kıyasla yaklaşık iki kat daha fazla ilgili gen değişikliği buluyor. İnsan vücudundaki her hücre aynı DNA şablonunu taşır, ancak farklı hücre tipleri farklı genleri açar ya da kapatır; bu farkları tahmin etmek genomiğin çözülmemiş büyük problemlerinden biri.
İlk AlphaGenome, bir milyon harf uzunluğundaki bir DNA dizisini alıp pek çok dokuda binlerce deneyin özelliklerini paralel tahmin ediyordu. Google Deepmind'a göre bu paralel yaklaşım model kapasitesini fazla yayıyor ve yakından ilişkili hücre tipleri arasındaki ince farkları yakalamayı zorlaştırıyordu. AlphaGenome 2 ise koşullu bir model: DNA dizisine ek olarak belirli bir biyolojik durumu girdi olarak alıyor ve etkileri o hücre tipi için hesaplıyor. 68 dokudan insan ve fare kaynaklı 107 milyondan fazla tek hücre profiliyle eğitildi.
Model, bir genin ne kadar güçlü ifade edildiğinin yanı sıra DNA'nın çekirdekte fiziksel olarak nasıl paketlendiğini, yani genomun hangi bölgelerinin erişilebilir olduğunu da hesaplıyor. Genleri susturan ya da aktive eden moleküler anahtarlar olan DNA metilasyonunu da tahmin edebiliyor. Tek bir ölçümden eksik veriyi çıkarabiliyor; örneğin yalnızca hücrenin gen aktivitesi ölçüldüğünde, DNA bölgelerinin ne kadar sıkı ya da gevşek paketlendiği gibi ek özellikler için tahmin veriyor. Bu, araştırmacıların hangi laboratuvar deneylerine öncelik vereceğine karar vermesine yardımcı oluyor. Model ticari olmayan araştırma için kullanıma açık.